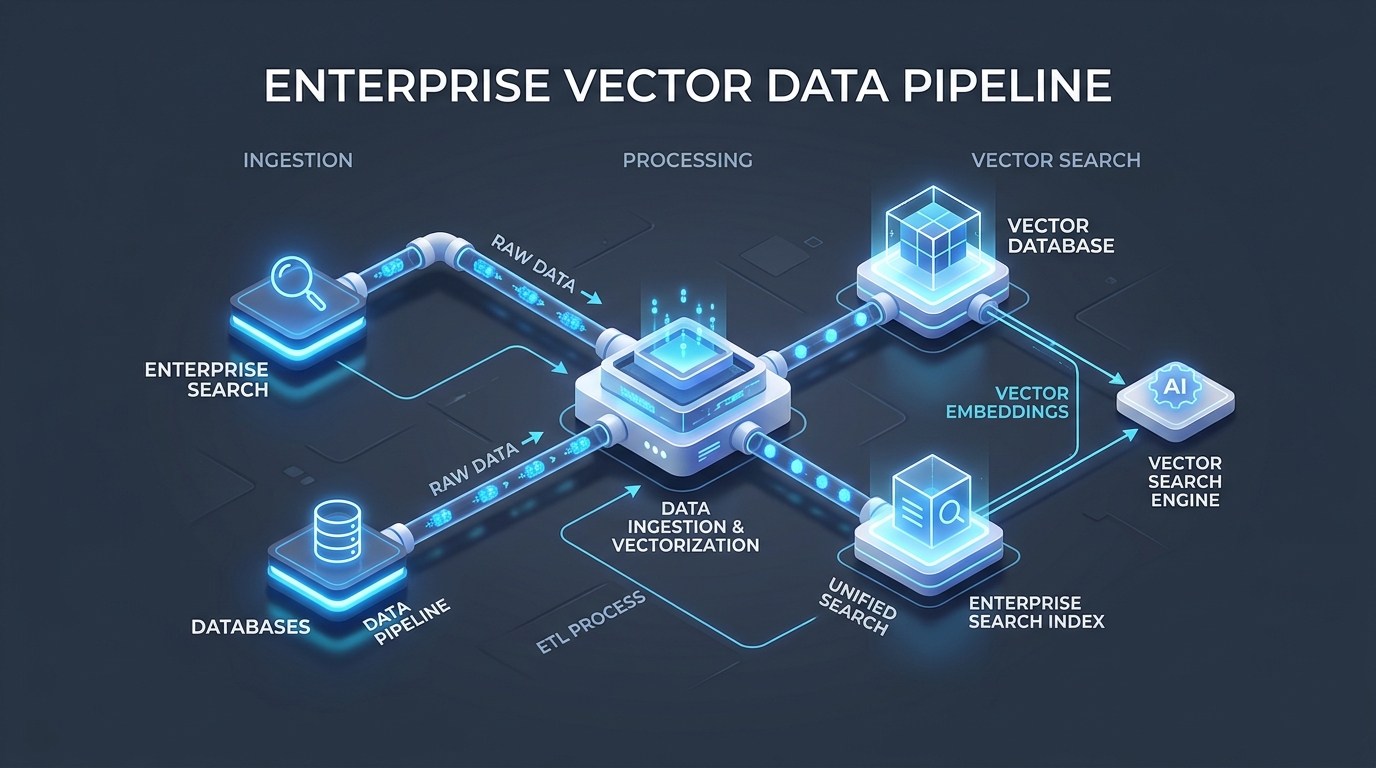
Tantangan mendasar dalam menghubungkan basis data internal dengan model bahasa besar selalu berputar pada dua kendala utama: biaya komputasi dan jendela konteks yang terbatas.Melatih ulang (fine-tuning) model secara penuh membutuhkan biaya ribuan dolar dan sering kali menghasilkan halusinasi yang sulit diawasi.Lapisan Penyimpanan: Dokumen internal dipecah menjadi potongan-potongan teks (chunks) terstruktur dan diindeks ke dalam database vektor ringan.
Pencarian Semantik: Ketika pengguna mengajukan pertanyaan, sistem mencari 3-5 potongan dokumen yang paling relevan secara matematis.
Sintesis Konteks: Potongan dokumen tersebut disuntikkan ke dalam prompt sebagai satu-satunya rujukan resmi bagi model AI untuk merumuskan jawaban.
Arsitektur RAG Enterprise Hemat Biaya: Menghubungkan Dokumen ke Model AI
Panduan mendalam tentang pondasi sistem temu-kembali informasi (Retrieval-Augmented Generation) yang efisien tanpa server GPU mahal.
Samuel Koesnadi··5 menit baca
Bimbelai mendampingi individu dan bisnis membangun sistem AI mandiri dan berdaulat.
Jelajahi platform →